
昨天結尾我說要把跑那兩張表的條件記下來。前兩天要 Apple Silicon 的 Mac 才跟得上,今天不用,手邊沒有本機模型也照樣做得完。
今天動手之前,先講一件我打開存檔才發現的事。
第 27 天我跑了兩輪。第一輪用的類別描述有兩條是我憑印象寫的,第二輪換成 CWE 官網原文。兩輪都留了存檔:第一輪在 hunt-firstdraft/,換掉描述之後那輪在 hunt/。
hunt.py 每跑完一輪會寫一份 run.json,記著它認為值得記的東西。我當初寫的是這樣:
{"model": MODEL.name, "renamed": RENAME, "alias": alias,
 "classes": len(results), "total_seconds": round(total, 1), "results": results}
有記模型。看起來該記的都記了。
我把兩輪的 run.json 讀出來比:
hunt            -> model: antares-1b-mlx, classes: 13, total_seconds: 83.4
hunt-firstdraft -> model: antares-1b-mlx, classes: 13, total_seconds: 75.8
一樣的模型、一樣的十三個類別。拿來描述執行條件的那幾欄(模型、有沒有改名、檔名對照、類別數)兩輪逐字相同。不同的是計時,而那個數字每跑一次都會變。
然後看正規表示式效能那一題。第一輪它指了 server/tools.js:
The `dig` command is part of the `dig` tool, which is a DNS client. DNS tools
often use regular expressions internally.
第二輪,同一個模型、同一份程式碼、--temp 0 沒動,它答的是:
None of the files contain suspicious regex patterns that could lead to
exponential backtracking.
一個指了檔案,一個說沒有。
兩輪的存檔我逐題比過。十三題裡有十一題的輸出逐字相同,一個位元組都沒差,只有被我改過描述的那兩題不一樣。也就是說這兩輪之間幾乎什麼都沒變,而那個「幾乎」就是答案翻掉的原因。
要分辨這兩輪,我只能靠答案自己不一樣,那已經太晚了。
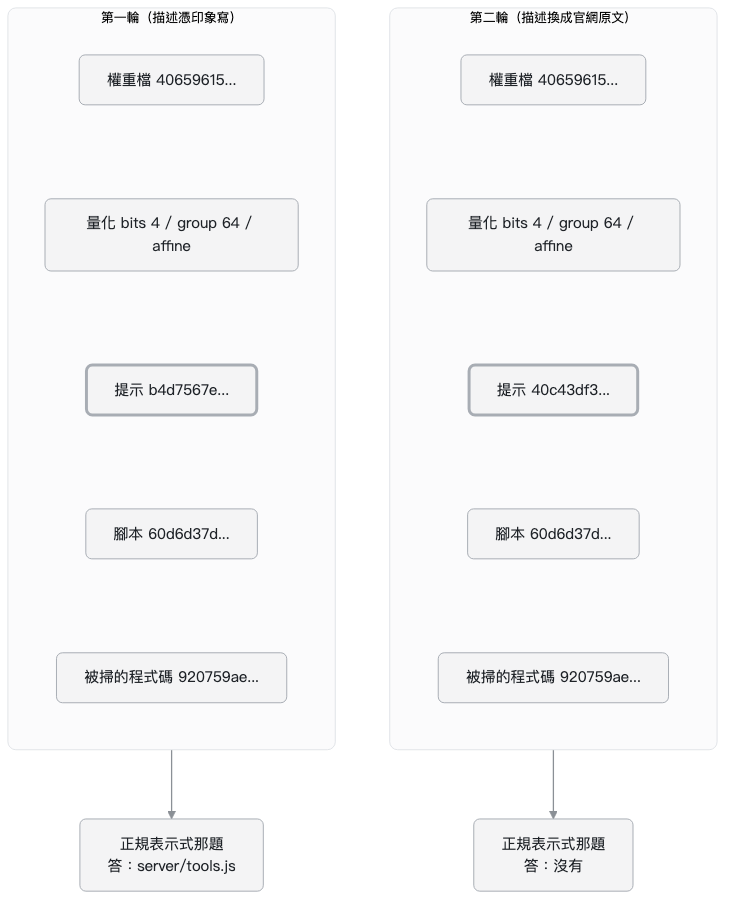
這張圖要看兩欄的第三格。五樣條件裡只有它不一樣,底下的答案是十三題裡的其中一題。而兩輪各自寫出的那份 run.json,記的只有第一格那個目錄名。
我記了模型,但改變答案的那樣東西我沒記。 三個月後翻到這兩份存檔,我只會看到兩個一模一樣的 model 欄跟兩個不同的答案,然後開始猜。
換成一般的程式,這件事不會發生。同一支函式、同一組輸入,我把參數的說明文字改個講法,回傳值不會跟著變。但那段描述是餵給模型的,而它讀到的東西沒有「這句只是說明」這種分別。
所以要記的東西比平常多,而且多出來的那些,正好是平常最不會被當成設定的東西。
第 26 天我寫了一份能力聲明存在 recipe 裡(POSITIONING.md),結尾有這麼一行:
什麼情況下這份聲明要重寫:換模型、換量化版本、換提示、換掃描的語言。
那句話當時是講給自己聽的。它列出了四樣東西,而我的 run.json 只記了第一樣,還是記成一個目錄名字。
前三樣直接對得上:模型、量化版本、提示。第四樣「換掃描的語言」提醒的是語言會影響結果,而要重現一輪實驗,光記語言不夠,得記實際掃了哪幾個檔。
我另外加了一格:跑它的那支腳本。那份聲明沒提到,但問法變了答案就會變,這件事第 27 天已經看過一次。
拿雜湊來記是因為它只做一件事,把一整個檔案壓成一串固定長度的字,內容動一個位元組那串字就換掉。
| 記什麼 | 怎麼取 |
|---|---|
| 權重檔 | model.safetensors 的 sha256 |
| 量化參數 | config.json 裡 quantization 那格(見下) |
| 提示 | 樣板加上十三條類別描述,只取模型讀得到的三欄 |
| 腳本 | hunt.py 的 sha256 |
| 被掃的程式碼 | 那七個檔的檔名與內容,一起算一個雜湊 |
跑一次 record,五格就寫進 stamp.json:
python3 stamp.py record /path/to/antares-1b-mlx
5 格記進 stamp.json:
  model	40659615c63f596296491c79f2d6b7bf71cdcaf8888c092d69d05ddc2b1210d8
  quant	{"bits":4,"group_size":64,"mode":"affine"}
  prompt	40c43df3314f5dcd1175d5296906346d2affb62c21a59e3e8c27f65faa8b5f4e
  script	60d6d37dff737d6b72ecd83466801ec9e809870c49cce96ae1bc8dd701ff3d7b
  corpus	920759aea0808a91d050e5e81b196db69e1c51d208175bbf30221279b5068536
量化參數那格嚴格說不是獨立的一樣。我手上這份權重就是量化之後的產物,換個位元數重跑一次量化,出來的是另一個檔,第一格會先攔到。留著它是因為雜湊只告訴你「不一樣」,這一格告訴你「哪裡不一樣」。
stamp.json 跟程式碼一起進版控。之後每次跑實驗前先 check 一次,有格子對不上就先停下來看是哪一樣變了。
一個 1.03 GB 的權重檔算完 sha256,我這台花 2.6 秒。跑一輪掃描本身要八十幾秒,對帳這一下是零頭。
一支對帳腳本最容易壞的方式,不是算錯雜湊,是某一格根本沒在比。那種壞法從輸出看不出來,因為它印出來的字跟真的對過一樣。
所以我拿第 27 天那張「換描述之前」的表回頭對一次帳:
python3 stamp.py check /path/to/antares-1b-mlx --cwes ../27-ask-by-cwe/cwes-firstdraft.tsv
  通過	model	40659615c63f596296491c79f2d6b7bf71cdcaf8888c092d69d05ddc2b1210d8
  通過	quant	{"bits":4,"group_size":64,"mode":"affine"}
  沒過	prompt	表上 40c43df3.../實測 b4d7567e...
  通過	script	60d6d37dff737d6b72ecd83466801ec9e809870c49cce96ae1bc8dd701ff3d7b
  通過	corpus	920759aea0808a91d050e5e81b196db69e1c51d208175bbf30221279b5068536

1 格對不上:prompt。
四格通過、一格不合,而不合的那格就是當初被我動過的那一樣。「表上」是 stamp.json 記著的,「實測」是拿舊那張表當場重算的。
昨天我只能寫「我改的是那兩段描述」,那句話靠的是我記得。今天它是一個算得出來的雜湊。
這裡有個選擇要做,寫這支腳本我就是卡在這裡最久。
提示樣板寫在 hunt.py 裡面,類別描述在另一個 cwes.tsv。最省事的做法是整支 hunt.py 算一個雜湊,反正提示也在裡面。
但那樣一來,我改一行註解,prompt 那格會跟著動。而下次對帳出現「提示變了」的時候,我要的答案是「提示真的變了」,不是「有人動過那個檔」。
所以 prompt 那格只取 PROMPT = """...""" 那段樣板,加上 cwes.tsv;script 那格才是整支腳本。驗證方式是在 hunt.py 尾巴加一行註解再對一次:
  通過	prompt	40c43df3314f5dcd1175d5296906346d2affb62c21a59e3e8c27f65faa8b5f4e
  沒過	script	當初 60d6d37d.../現在 051d202e...
只有 script 那格動了。
成分的邊界是人畫的。 畫太粗的下場是每次動那個檔就有兩格一起變,而你分不出哪一次是提示真的改了。
同一條線我在另一邊畫錯過。第一版的提示那格是整份 cwes.tsv 算一個雜湊,而那張表有四欄,其中第二欄是我自己填的人工答案,hunt.py 從來沒把它餵給模型。所以我改一格答案、模型讀到的東西一個字都沒變,那一格照樣報不合。
這個方向比漏記更麻煩:漏記是該響沒響,這個是不該響卻響了,而人對假警報的反應是關掉它。現在那一格只算模型真的讀得到的編號、標題、描述三欄。
第 20 天記判斷點的時候我寫過一句:雜湊只吃得到你餵給它的東西。那天我還補了一句,說託管模型背後的權重拿不到,只能記提示的雜湊。
今天那一格終於填得起來了,因為模型就在這台機器上,那個檔我算得動。這是 Part V 收回本機之後多出來的東西之一。
寫到這裡容易滑進另一個題目:既然都在算雜湊了,是不是能擋掉有人偷換你的權重?
不是。權重、stamp.json 跟驗證腳本全在同一台我自己寫得動的機器上,所以這張表擋不住任何一個寫得動這台機器的人:他改完權重順手改掉 stamp.json,對帳照樣通過。
sha256 在這裡只是「模型是哪一份」那一格的填法。
這張表要對付的是三個月後的自己,不是攻擊者。
第一版我只記了四樣,漏掉被掃的那份程式碼。我改了 playground/src/api.js 一行再對一次帳,四格全部通過。
我這篇通篇在罵舊 run.json 記得不夠,而我的替代品漏了比它更大的一項。 現在補成第五格了,但這件事得留在文章裡:一張成分表不會因為它是新的就比較完整。
五格記的是材料。材料之外還有兩類東西會動答案,它們一樣都不在表裡。
一類是這一輪怎麼跑的。 hunt.py 有個 --rename 旗標,跑它會把七個檔名換掉再餵給模型,磁碟上的檔一個都沒動,所以五格完全相同。同型的還有問了哪幾條:提示那格算的是整份 cwes.tsv,下次我只問 CWE-78 一類,五格照樣全過,輸出從十三份變一份。
舊的 run.json 開頭那行有 "renamed": RENAME。它記了那個旗標,我的五格沒有。
另一類是跑在什麼上面。 第 26 天我把環境釘到版號寫進文章:M4 Pro、Python 3.11.8、mlx-lm 0.31.3。這五格一個字都沒記它。換一台機器、升一版推論套件,五格全部通過。這一項我沒有實際換版重跑過,所以不知道會差多少;但這篇開頭那兩份存檔的差距,就是一個檔名對上一句「沒有」。
這一類最麻煩,因為它是無聲的。--rename 是我自己打的旗標,我知道我打了;mlx-lm 升版是某天跑 pip install -U 順手升的,而下次對帳照樣五格全過。
所以「五格都對得上」的意思只有一個:這五樣沒變。 不是「條件都一樣」。用之前先問一次,這一輪有沒有哪個條件是從表外面進來的。
五格,加上一支跑實驗前先對帳的腳本。recipe 28 裡有十節檢查,其中五節要真的模型,另外三節用一個幾位元組的假模型目錄就驗得掉,剩下兩節連那個都不用。
我也把每一節各弄壞一次。前面說的那個「永遠說對得上」就是其中一條,我真的把它改成那樣跑過一次。
這四份今天都沒動。今天長的是第五份:一份五格的成分表。
要講清楚這份表現在管得到哪裡:它對得上的是第 27 天那一輪。第 26 天那份逐檔掃描用的是另一支腳本,還有一份九列的核對表,兩樣都還沒有自己的成分表。
最後一天要把每一列結果分成過了、沒過、沒測。到那時候,對不上的那幾列不能算過,沒有成分表的那幾列也不能算過,兩種都得標成要重跑。這張表就是那時候的判準。
前面二十八天,每個洞我都是一個一個看的。第 5 天那行把回答塞進 innerHTML 的程式碼、第 11 天那個「你看見的網頁,不是模型讀到的那一份」,各自都有結論。
但那些結論都是單點的。明天我要挑兩個「單獨看都沒問題」的地方,試試看串起來會不會通。而那一輪如果真的走通了,我得說得出它是拿哪一份權重、哪一版提示跑的。不然那條鏈就跟今天開頭那兩份存檔一樣,沒人能重驗。


 iThome鐵人賽
 看影片追技術